华为盘古大模型是华为旗下的盘古系列AI大模型,由华为云、循环智能和鹏城实验室联合开发,研发首席科学家为田奇。2021年4月,盘古大模型在华为开发者大会上正式对外发布,初始阶段主要包含NLP、CV和科学计算三大基础模型。
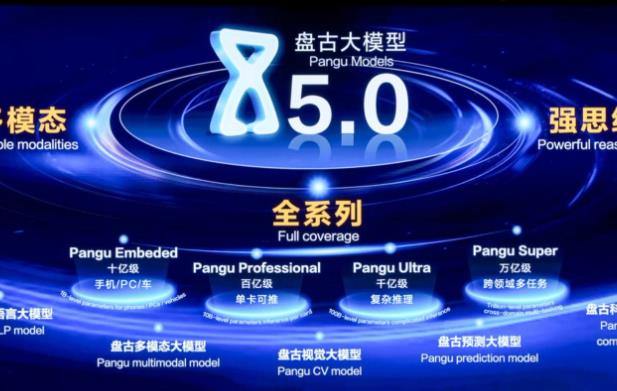
从版本谱系来看,盘古大模型已发展出以下主要版本线:
基础大模型五大系列:盘古大模型包括盘古NLP大模型、盘古CV大模型、盘古多模态大模型、盘古预测大模型、盘古科学计算大模型五大基础模型。这五大基础模型构成盘古的L0层通用能力底座,经过千亿级参数的预训练形成跨行业的通用能力。
大版本迭代主线:盘古1.0(2021年4月)→ 盘古2.0(2022年4月,确立L0/L1/L2分层架构)→ 盘古3.0(2023年7月,确立5+N+X分层架构)→ 盘古5.0(2024年6月,引入可控时空生成STCG技术)→ 盘古5.5(2025年6月,五大基础模型全面升级)→ openPangu 2.0(2026年6月,全尺寸开源)。
NLP大模型版本系列:N1轻量化系列(十亿级,快思考模型)→ N2性价比系列(百亿级,快慢思考融合)→ N4系列(更大规模,支持长序列)。N2系列是当前主力版本,支持32K和128K两种序列长度,具备快慢思考融合能力。
CV大模型版本系列:2023年4月首个视觉大模型发布 → 2024年6月整合至5.0体系 → 2025年升级为300亿参数的MoE架构,是目前业界最大的视觉模型。
科学计算大模型版本系列:盘古气象大模型(2023年)→ 盘古海洋大模型 → 盘古生态大模型 → 盘古海浪大模型,覆盖全球和区域两个尺度,时间分辨率从1小时到24小时不等。
开源系列:2025年7月开源盘古70亿参数稠密模型和盘古Pro MoE 720亿参数混合专家模型。2026年3月,华为宣布盘古大模型全尺寸矩阵开源,从718B旗舰到1B端侧全覆盖。
第二部分:各版本详细对比与拆解
一、大版本迭代核心对比
维度 盘古1.0 盘古2.0 盘古3.0 盘古5.0 盘古5.5 openPangu 2.0
发布时间 2021年4月 2022年4月 2023年7月 2024年6月 2025年6月 2026年6月
核心架构 NLP+CV+科学计算 L0/L1/L2分层 5+N+X分层 STCG技术 五大模型全面升级 全尺寸开源
参数规模 千亿级NLP 扩展行业模型 行业全覆盖 2300亿稠密+2.6万亿MoE 7180亿MoE 718B旗舰+72B+7B+1B
定位 通用能力验证 行业应用延伸 不作诗只做事 端云一体 自适应快慢思考 开放生态
盘古大模型从1.0到5.5的迭代路径清晰:1.0验证通用能力,2.0建立分层架构,3.0明确“不作诗,只做事”的行业定位,5.0引入可控时空生成技术并实现端云一体,5.5完成五大基础模型的全面升级。
盘古5.5版本最核心的突破是自适应快慢思考融合技术。NLP大模型推出了7180亿参数的MoE深度思考模型,由256个专家组成,在知识推理、工具调用、数学等领域能力显著增强。自适应快慢思考融合让模型可根据问题难易程度自动切换思考模式——简单问题快速响应,复杂问题调动更多算力进行推理,整体推理效率提升8倍。
二、NLP大模型各版本详细对比
维度 N1系列(轻量化) N2系列(性价比) N4系列(大规模)
参数规模 十亿级 百亿级 更大规模
上下文 32K / 128K 32K / 128K 4K / 32K
核心能力 对话问答、文案生成、阅读理解 数学推理、快慢思考融合 长序列训练
思考模式 快思考 快慢思考合一 快思考
部署单元 轻量部署 32个推理单元(Reasoner-128K) 8个推理单元(128并发)
适用场景 效率优先的轻量任务 默认优选,兼具效果与性能 大规模推理部署
盘古NLP大模型是业界首个超千亿参数的中文预训练大模型,结合了大量数据预训练和多源知识,借助持续学习不断吸收海量文本数据。N2系列是当前默认最优选模型,兼具模型效果和推理性能,擅长回答数学和推理问题。N2-32K-5.0.3.2版本实现了快慢思考融合,工具能力进一步加强,RAG幻觉显著降低。N1系列定位轻量化,适合在对效率要求较高的环境中部署使用。N4系列面向大规模推理部署,支持128并发,适合企业级高吞吐场景。
三、CV大模型版本对比
盘古CV大模型于2023年4月作为首个视觉大模型正式发布,2025年升级为300亿参数的MoE结构,支持多维度泛视觉感知、分析与决策。这是目前业界最大的视觉模型,全面支持图像、红外、激光点云、光谱、雷达等多维度感知。
CV大模型在ImageNet小样本学习任务中数据需求减少80%以上,支持图像分类、物体检测等近10种微调任务。在矿山场景中,CV大模型实现设备异常检测精度提升至业界领先水平,推理延迟控制在8ms以内,检测准确率达98.7%。城轨车辆360°检测方案的图像识别准确率超过95%,误报率降低50%。
四、科学计算大模型版本对比
模型系列 时间分辨率 核心能力 最新版本
Pangu-AI4S-Global-Weather 1h/3h/6h/24h 天气基础要素预测 v4.1.4(2025年9月)
Pangu-AI4S-Regional-Weather 1h 区域中期天气预测 v1.1.4(2025年9月)
Pangu-AI4S-Global-Ocean 24h 海洋基础要素预测 v2.1.4(2025年9月)
Pangu-AI4S-Global-Swell 3h 全球海浪预测 v2.1.4(2025年9月)
Pangu-AI4S-Global-Precip 6h 降水预测 v1.1.4(2025年3月)
盘古科学计算大模型面向气象、医药、水务、机械、航天航空等领域,融合了AI数据建模和AI方程求解方法。该模型从海量数据中提取数理规律,利用神经网络编码微分方程,通过AI模型更快速、更精准地解决科学计算问题。
其中盘古气象大模型采用3D Earth-Specific Transformer(3DEST)网络架构,在气象预测领域实现1小时至7天的预报精度超越传统数值方法,预测速度比传统数值预报提升10000倍以上,相关研究成果于2023年7月发表于国际顶级期刊《自然》。香港天文台于2023年10月成为首个应用盘古气象大模型的业务机构,用于台风路径预测。
第三部分:为什么分这么多版本?
一、场景适配:从通用底座到行业深耕
盘古大模型采用5+N+X三层设计,这一分层解耦架构是其版本分化的核心逻辑。L0层包含NLP、CV、多模态、预测及科学计算等五个基础大模型,经过千亿级参数的预训练形成通用能力底座。L1层是在基础模型之上通过行业数据注入训练形成的行业大模型,覆盖政务、金融、制造、矿山、气象等领域。L2层则聚焦具体业务场景进行精调,提供场景化的模型服务。
这种分层设计的价值在于:客户可以独立加载数据集、单独升级基础模型或能力集,也可根据数据安全和合规需求选择公有云、大模型云专区或混合云等部署形态。山东能源集团的案例充分说明了这一价值——传统单场景小模型方案在实践中存在“在一个矿井生产场景训练的模型,转移至其他矿井往往需要重新训练,成本高、周期长”的问题,而盘古大模型的模型移植能力使相似场景上训练的模型迁移到未训练的新场景时识别精度超过23%,可节省85%的标注人力。
二、全栈自主:昇腾芯片与盘古模型的深度协同
盘古大模型的另一核心差异化在于其全栈自主性——面向昇腾训练的全新架构意味着盘古大模型是基于昇腾芯片进行训练的,拥有独特的架构设计。2025年6月发布的新一代昇腾AI云服务采用CloudMatrix 384超节点架构,将384颗昇腾NPU与192颗鲲鹏CPU通过全对等互联整合为一台超级AI服务器,单卡推理吞吐量达到2300 Tokens/s,相比非超节点架构提升约4倍。
这一全栈自主的架构使盘古在政务、金融、能源等对数据安全和合规要求严格的行业中具有天然优势。龙岗区教育局选择盘古的核心原因正是“保障教育数据安全与师生隐私的根基”,“不再是通用模型的被动用户,而是深度参与、共同建设的主人翁”。
三、开源分层:从自研闭环到开放生态
2026年3月,华为宣布盘古大模型全尺寸矩阵开源,从718B旗舰到1B端侧全覆盖,同时接入160余个主流模型,完成从“自研闭环”到“开放生态”的战略转向。开源版本作为技术标杆吸引开发者构建应用生态,而旗舰版本通过华为云ModelArts Studio平台提供API服务实现商业变现。
这一开源策略的商业价值在于:通过开源降低企业二次开发门槛,华为云同步提供后训练套件——CPT、SFT、RL全流程工具,帮助企业基于自有数据打造专属行业模型。ModelArts Studio平台提供全流程开发支持,截至2025年累计支撑超过200个行业解决方案,产业应用实现数据处理效率5倍以上提升。
第四部分:最著名版本——盘古NLP大模型本地化部署实战
盘古NLP大模型是盘古系列中应用最广泛的基础模型,也是业界首个超千亿参数的中文预训练大模型。以下以盘古NLP大模型为例,给出完整的本地化部署步骤。
步骤一:环境准备与硬件规划
硬件配置基准:
基础配置:NVIDIA A100/V100 GPU或RTX 4090,显存16GB以上
推荐配置:NVIDIA A100 80GB,适用于N2系列模型加载
N4大规模部署:8个推理单元支持128并发
内存:32GB起,推荐64GB以上
存储:预留50GB以上用于模型文件与数据集
软件环境清单:
操作系统:Ubuntu 20.04 LTS
CUDA 11.7+,cuDNN 8.x
Python 3.8+
PyTorch 2.0+(支持混合精度计算)
步骤二:安装依赖环境
bash
# 创建虚拟环境
conda create -n pangu_env python=3.8
conda activate pangu_env
# 安装核心依赖
pip install torch transformers
pip install fastapi uvicorn
pip install bitsandbytes # 量化支持
步骤三:获取模型权重
从华为云申请模型下载权限后,通过wget命令获取预训练权重文件。
bash
# 登录华为云ModelArts Studio平台
# 在模型管理页面选择目标NLP模型版本
# 获取下载链接后执行:
wget -O pangu-nlp-n2-32k.tar.gz <模型下载链接>
tar -zxvf pangu-nlp-n2-32k.tar.gz -C ./pangu-model
步骤四:模型优化配置
针对低配设备,需通过量化技术压缩模型体积。量化技术可将参数精度从32位浮点降至4位整数,减少75%显存占用;梯度检查点技术通过动态释放中间变量,降低30%内存需求。
python
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
# 加载模型(8bit量化)
model = AutoModelForCausalLM.from_pretrained(
"./pangu-model",
torch_dtype=torch.float16,
device_map="auto",
trust_remote_code=True,
load_in_8bit=True
)
tokenizer = AutoTokenizer.from_pretrained(
"./pangu-model",
trust_remote_code=True
)
步骤五:服务化部署
使用FastAPI创建RESTful API,实现接口封装:
python
from fastapi import FastAPI
from transformers import AutoModelForCausalLM, AutoTokenizer
app = FastAPI()
tokenizer = AutoTokenizer.from_pretrained("./pangu-model")
model = AutoModelForCausalLM.from_pretrained("./pangu-model")
@app.post("/predict")
def predict(text: str):
inputs = tokenizer(text, return_tensors="pt").to("cuda")
outputs = model.generate(**inputs, max_new_tokens=512)
return {"result": tokenizer.decode(outputs[0], skip_special_tokens=True)}
启动服务:
bash
uvicorn main:app --host 0.0.0.0 --port 8000
步骤六:部署验证
通过三步验证部署有效性:基础推理测试、性能调优、服务化部署验证。
bash
# 基础推理测试
curl -X POST http://localhost:8000/predict \
-H "Content-Type: application/json" \
-d '{"text":"盘古大模型的优势是"}'
步骤七:性能优化
启用FlashAttention加速注意力计算,可使推理速度提升40%;通过torch.jit.trace将模型转换为图模式,减少运行时开销。对于快慢思考融合的N2系列模型,可通过system prompt控制推理方式切换:
python
# 快思考模式(简单任务)
system_prompt = "请快速简洁地回答以下问题。"
# 慢思考模式(复杂推理)
system_prompt = "请仔细分析并逐步推理以下问题。"
第五部分:不同版本的实践成果
案例一:山东能源集团盘古矿山大模型(基于盘古CV大模型 + NLP大模型)
山东能源集团依托华为盘古大模型建设了集团人工智能训练中心,这是盘古大模型在矿山领域的首次商业部署,探索采、掘、机、运、通、洗选等全场景的人工智能应用。
实践成效:通过云边协同方案,AI标杆煤矿兴隆庄煤矿的一处训练可实现全集团共享,未来可复制到集团其他70余座矿井。大模型相比小模型有良好的泛化性能,在相似场景上训练的模型迁移到未训练的新场景时识别精度超过23%,可节省85%的标注人力,同等少量样本训练情况下大模型精度高出小模型10%。在矿山场景中,盘古CV大模型推理延迟控制在8ms以内,检测准确率达98.7%。
案例二:交通银行人工智能联合创新成果(基于盘古预测大模型 + NLP大模型)
2024年7月5日,交通银行在2024世界人工智能大会上正式发布人工智能联合创新成果。该成果基于华为昇腾硬件构筑算网存云高效协同的基础底座,盘古大模型提供基础模型能力,赋能交通银行人工智能高价值业务场景。
实践成效:华为将盘古大模型中的预测大模型应用于财务智能预警场景,提供企业财务异常识别和手段分析,准确率从65%提升到90%以上,并升级应用于银行资产负债调度,智能辅助日间上千亿资金头寸的运营决策。广发证券应用盘古大模型优化企业财务智能预警系统,将机器学习模型的精度从79%提升到90%,对企业的财务欺诈行为发现更为精准。广东省农信社通过盘古金融OCR大模型将字段识别精度从83.9%提升至91%,还可实现用一个模型覆盖多个通用的文字识别场景。
案例三:天津港集团PortGPT港口大模型(基于盘古CV大模型)
天津港集团联合华为公司组建专项技术团队,依托华为盘古CV大模型,自主打造PortGPT港口垂直领域大模型,创新构建CV大模型与多模态大模型融合的全流程智能化解决方案。该项目在港航大模型智能体创新应用大赛中斩获特别荣誉卓越创新奖。
实践成效:项目搭建专属港口专业样本库,建立涵盖“人、机、车、场、船、货”六大类23项核心要素的智能识别体系。模型识别准确率超93%,智能告警精准率平均达到97%,自2025年四季度至今同点位告警数量下降80%以上。项目成果已全面落地集团公司各核心作业场景,构建起全层级、全场景的AI视频智能分析能力,为港口智能化安全管理筑牢技术根基。
版权声明:本平台仅提供信息存储空间服务,用户发布内容不代表本站观点,交易风险自担;侵权违法内容请立即举报(邮箱:37996619@qq.com),本站接通知后先行屏蔽,责任由发布者承担。