AI专用服务器租赁,是指用户无需自行购买价格高昂的AI计算硬件,而是通过云服务商、算力租赁平台或专业服务商,按需租用专为人工智能应用设计的高性能服务器的一种服务模式。
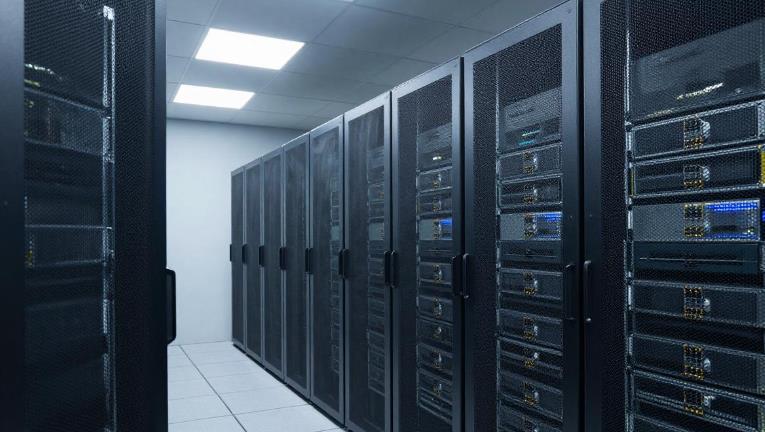
一台AI专用服务器与普通服务器的核心区别在于硬件架构。它采用“CPU+加速器(GPU/TPU/NPU)”的异构计算架构,集成多个高性能GPU、大容量内存和高速存储,以应对海量数据的并行处理需求。一个典型的AI服务器系统由多个GPU(通常是八个)通过高速互连连接而成,GPU负责训练和运行AI模型的繁重数学运算。一台高端GPU服务器动辄几百上千万,对于大多数企业、团队和个人开发者来说,自购几乎不可能。
从服务交付形态来看,AI专用服务器租赁主要分为以下几种:
裸金属租赁(Bare Metal Rental)
用户获得整台物理服务器的独占使用权,没有虚拟化层带来的性能损耗。这是AI模型训练场景下的首选——多卡训练对NVLink互联和网络带宽要求极高,裸金属可以确保性能零损耗。以8卡RTX 4090裸金属为例,月租约7920元。
云GPU实例/容器化租赁
用户租用虚拟化的GPU计算实例,按小时或分钟计费,支持秒级启动和弹性伸缩。适合短期实验、代码调试和推理任务。RTX 4090时租仅1.96元。
Token计费模式(按产出付费)
用户不再按租用GPU的时长付费,而是按实际消耗的Token数量付费——好比从“按小时租厨房”变成“按出餐份数收费”。这是AI推理场景下最具成本优势的模式,适合直接调用大模型API完成任务的场景。
一站式AI平台服务
平台将算力资源、预装镜像、Token额度、操作系统等一体化打包,用户开机即可运行各类AI应用。适合不想折腾技术部署、希望“开箱即用”的用户。
从产业链演进来看,AI专用服务器租赁正经历从“场地托管”到“裸金属租赁”再到“托管云服务(Neocloud)”的三阶段跃迁。每多一层服务封装,合同价值就从约178万美元/MW/年跃升至970-1100万美元/MW/年以上——这背后反映的是算力服务从“租硬件”到“租能力”的深刻转变。
二、两个常见疑问与解答
疑问一:AI专用服务器租赁和普通云服务器租赁有什么区别?
两者的核心区别不在“服务器”本身,而在“算力”和“服务”的深度。
普通云服务器以CPU计算为主,适合网站托管、数据库、企业应用等通用场景。而AI专用服务器以GPU等加速芯片为核心,专门为深度学习训练、大模型推理、3D渲染等高并行计算任务设计。
更深层的区别在于服务形态。普通云服务器租赁是“租一台电脑”——你拿到的是虚拟机,自己装系统、配环境、部署应用。而AI专用服务器租赁正在从“租硬件”走向“租能力”:
裸金属租赁:你租的是整台物理服务器,自己掌控一切——适合需要完全控制环境的训练团队。
云GPU实例:你租的是虚拟化算力,平台帮你搞定底层——适合需要弹性伸缩的开发测试。
Token计费:你连服务器都不用管,直接按产出付费——适合只想调用AI能力的应用开发者。
建议:如果你的需求是AI训练、推理或渲染,优先考虑AI专用服务器租赁而非普通云服务器;如果是常规业务系统,普通云服务器即可满足。
疑问二:AI专用服务器租赁是不是只有大公司才用得起?个人或小团队能用吗?
恰恰相反,AI专用服务器租赁最大的价值之一,就是让个人开发者、中小企业和初创团队用得起高性能AI算力。
从价格来看,入门门槛已经极低。RTX 4090云GPU时租仅1.96元——跑一晚上也就十几块钱,比一杯奶茶还便宜。极智算的新用户还能免费用5小时。对于学生和学术研究者,AutoDL的RTX 3090时租约1.20元。2026年一季度算力租赁市场规模已达680亿元,同比增62%,全年预计突破2600亿元——市场的快速扩张正在让算力从“奢侈品”变成“日用品”。
工信部2026年印发的普惠算力专项行动明确提出,要显著降低中小企业获取、使用算力的门槛。“算力超市”“算力银行”等创新模式正在让算力从需要一次性投入巨额资金的重资产变成可以按需购买、灵活使用的轻服务。
AI专用服务器租赁不是大公司的专利,而是所有有AI算力需求者的普惠工具。
三、AI专用服务器租赁的核心好处
1. 大幅降低硬件投入门槛
一台8卡GPU服务器动辄百万级别,加上机房、电力、散热、运维,总投入轻松过千万。租赁模式将资本性支出转变为灵活的运营性支出——企业无需一次性大额投入,以月租或按使用量付费为主,现金流压力分散、弹性可控。相比自建算力集群,综合使用成本可降低60%以上。
2. 弹性伸缩,按需付费
AI算力需求具有明显的潮汐特征——训练高峰期需要大量算力,平时需求锐减。租赁模式支持按小时、按天、按月灵活租用,资源随用随放。企业可以根据项目进度灵活调整算力规模,避免资源闲置浪费。
3. 规避技术迭代风险
硬件更新换代极快。2026年高端GPU租赁价格半年内涨幅约40%,但更关键的是技术迭代——今天买的旗舰GPU可能两年后就落后了。租赁模式让用户始终可以租用最新的算力资源,无需承担设备折旧和技术淘汰的风险。
4. 开箱即用,快速启动
传统自建方式下,从采购到部署完成至少需要数周甚至数月。而租赁模式下,用户从提交需求到获得算力通常只需数小时,部分平台支持“分钟级交付”。专业平台预装了PyTorch、TensorFlow等主流框架和CUDA环境,用户拿到即可开始工作。
5. 专业运维,省心省力
AI服务器集群的部署、运维、调优需要专业技术团队。选择租赁后,硬件维护、系统升级、安全防护全部由平台负责。用户只需专注于自己的核心业务和算法研发。
四、如何租赁AI专用服务器——分步指南
第一步:明确自身需求
在接触任何平台之前,先回答几个关键问题:
做什么用?模型训练需要多卡集群和NVLink互联;推理任务更关注显存大小和并发能力;开发调试可以用单卡按小时租。
用多久?一周以内选按小时计费;一个月以上选包月,折算单价能便宜30%-40%。
要几卡?模型大小决定显存总量,再倒推卡数和单卡规格。7B参数模型推理单卡A10即可;70B模型微调至少需要4-8卡集群。
数据敏感度?敏感数据需要物理隔离或专属集群。
第二步:选择适合的平台类型
根据需求匹配平台:
平台类型 代表平台 价格水平 适合谁
头部云厂商 阿里云、华为云、腾讯云 偏高 大型企业、对SLA要求高的生产级业务
专业算力平台 极智算、智星云 中低 中小企业、创业团队
学术社区平台 AutoDL 最低 学生、个人开发者
去中心化平台 Vast.ai、RunPod 灵活定价 追求性价比的技术用户
第三步:关注选型关键指标
选平台时不要只看“卡时单价”:
单卡显存与NVLink:单卡显存多少、NVLink是否打通。多卡训练时NVLink带宽利用率可达95%以上,没有NVLink的多卡等于废铁。
节点间带宽与存储:节点间带宽是多少、存储是否SSD。共享存储I/O延迟过高会导致GPU空转率超过60%。
SLA与技术支持:云厂商SLA普遍在99.95%以上;专业平台SLA 99.9%,硬件故障4小时内响应。
计费透明度:72%的用户曾遭遇隐性消费,平均多花25%。确认带宽费、存储费、出网流量费是否包含在报价内。
第四步:小规模试用验证
正式投入前,先进行小规模测试:
租用1-2卡运行1-2小时
验证算力性能是否达到预期(实际跑模型看速度,不要信宣传数据)
测试网络延迟和存储I/O是否稳定
体验平台的操作便捷性和技术支持响应速度
第五步:正式租赁与持续优化
确认平台和方案后正式启动:
短期任务选按小时/按Token计费,长期任务切换包月
部署AI开发环境和数据
持续监控GPU利用率、显存占用、任务排队时间等指标
定期复盘实际使用情况和成本,根据使用情况调整配置和计费模式
任务完成后及时释放资源,避免闲置计费
五、实践案例与结果
案例一:极智算8卡4090裸金属——7,920元/月,满足中小企业AI训练需求
2026年8月,极智算(JYGPU)官网刊例价显示,8卡RTX 4090裸金属服务器月租仅7,920元。同样配置在头部云厂商的价格通常在2-3万元/月以上。以某AI绘画团队为例,原本计划自购8卡4090服务器,硬件采购加机房托管首期投入超过30万元。通过租赁方式,月付不到8000元,一年总花费不到10万元,比自购节省了三分之二以上的初期投入,而且可以根据业务需求随时升级或降配。
案例二:Meta租用AWS Graviton5 CPU——数十亿美元级AI算力布局
2026年4月,Meta宣布与亚马逊AWS达成一项持续数年、价值达数十亿美元的合作,大规模租用AWS的Graviton5 CPU以支持其AI智能体业务。Graviton5 CPU基于ARM架构的3nm制程,每颗CPU拥有192颗核心。Meta将使用“数千万个核心”的Graviton CPU,正式成为AWS Graviton全球最大的客户之一。这一案例说明,AI专用服务器租赁不仅是中小企业的选择,也是科技巨头的战略选择——与其投入巨资自建全部算力,不如通过租赁实现灵活扩展。
案例三:鸿海亚湾超算5MW AI集群——首座HGX B300系统上线,9成使用率投入商业运营
2026年7月,鸿海旗下亚湾超算宣布首座采用NVIDIA HGX B300系统建置的5MW AI集群正式上线。集群采用水冷架构、2N高可用设计及NVIDIA Quantum-X800 InfiniBand高速网络,支持大型语言模型训练与推理需求。该集群已签下首批客户长期租赁合约,并以超过9成使用率投入商业运营。亚湾超算同步取得NVIDIA Exemplar Cloud认证,成为亚洲第二家通过NVIDIA生产级AI训练验证的NCP伙伴。这一案例说明,AI专用服务器租赁已经从“小团队的权宜之计”变成了“大企业AI商业化的标准路径”——大型AI集群以租赁形式服务客户,正在成为AI算力基础设施的主流商业模式。
版权声明:本平台仅提供信息存储空间服务,用户发布内容不代表本站观点,交易风险自担;侵权违法内容请立即举报(邮箱:37996619@qq.com),本站接通知后先行屏蔽,责任由发布者承担。